by Huenei IT Services | Oct 20, 2026 | Inteligencia Artificial
El debate terminó. El problema real acaba de empezar.
El 90% de los profesionales de tecnología ya usa IA en su trabajo. La pregunta ya no es si adoptarla. La pregunta es por qué la misma herramienta produce resultados radicalmente distintos según el equipo que la usa — y qué dice la evidencia sobre lo que realmente le está pasando a la calidad del código desde que comenzó la adopción masiva.
La respuesta corta: la IA no transforma a los equipos. Los amplifica. Y el principal factor de amplificación no es qué modelo usás. Es cuánto contexto estructurado tiene ese modelo para trabajar.
Lo que muestran los datos
Los números de las investigaciones 2025-2026 sobre desarrollo asistido por IA no son los que la mayoría de las organizaciones esperaba cuando desplegó licencias de Copilot.
−7,2% de estabilidad de entrega por cada 25% de aumento en adopción de IA sin governance que lo sostenga. (DORA / Google Cloud, 2025)
50% de todo lo que se incorpora a repositorios activos es hoy código generado por IA. El porcentaje que pasa los controles de seguridad: 56%. El 44% restante introduce una vulnerabilidad conocida — no porque el modelo sea descuidado, sino porque nadie le pidió que fuera seguro. (Veracode, 2026)
+81% de aumento en bloques de código duplicados por millón de líneas desde 2023. La tasa de descarte de código casi se duplicó. Las líneas efectivamente refactorizadas cayeron del 24-25% a menos del 10%. (GitClear, 2026)
Los pull requests crecieron un 20% interanual. Los comentarios de commit cayeron un 27%. La revisión de código no está siguiendo el ritmo de la generación de código.
El patrón es consistente: la IA escribe código más rápido de lo que la mayoría de los equipos puede revisar, integrar y refactorizar. Velocidad sin proceso no acelera la entrega. Acelera los problemas.
La causa raíz: lo que le das a la IA para trabajar
La mayoría de los problemas de calidad con IA no empiezan con el modelo. Empiezan antes de que se genere la primera línea de código — con requerimientos ambiguos, reglas de negocio que vivían en conversaciones informales y decisiones técnicas que nadie documentó.
La IA opera con lo que está escrito. Cuando el contexto que recibe es incompleto o desconectado de las restricciones reales del negocio, el output lo refleja — a escala. Esta es la causa raíz de la explosión de código duplicado, la brecha de seguridad y la caída en la tasa de refactoring.
La solución no es un modelo mejor. Es un contexto mejor estructurado.
Las dos prácticas que resuelven esto desde la raíz: PDD y SDD
Product-Driven Development (PDD) significa que el producto — sus objetivos, sus usuarios, sus restricciones de negocio — define el trabajo técnico antes de que el equipo empiece a construir. La IA opera con especificaciones orientadas al producto: sabe qué construir y por qué antes de proponer cómo.
Spec-Driven Development (SDD) convierte la especificación en la única fuente de verdad. Cada requerimiento, decisión de diseño y criterio de aceptación existe como un activo estructurado antes de que se escriba una línea de código. La especificación no es un documento que alguien escribe una vez y olvida. Es el activo central del que todo lo demás deriva.
El resultado: el retrabajo no desaparece porque la IA es más rápida. Desaparece cuando la especificación resuelve la ambigüedad antes de que el equipo empiece a construir.
Cómo fluye el contexto a través de las seis etapas de entrega
El contexto estructurado no es un input de una sola vez. Es un activo que avanza a través de todo el ciclo:
Prototipado — validación rápida contra restricciones reales de negocio, no contra supuestos.
Especificación — única fuente de verdad creada antes de que empiece cualquier generación.
Desglose — la especificación se convierte en estructura de tareas; la IA descompone el trabajo de forma consistente desde ella.
Ejecución — la IA genera dentro del contexto de la especificación; el output es auditable independientemente de quién lo escribió.
Testing — los casos límite se generan automáticamente desde la especificación, no se descubren tarde.
Reverse engineering — los sistemas existentes se documentan contra la especificación, cerrando el ciclo para iteraciones futuras.
Dónde el equipo nunca cede: la supervisión humana
La IA absorbe el trabajo de ejecución repetitivo para que el equipo pueda concentrar su energía en los cinco puntos donde el juicio humano es irreemplazable:
Contextualización del problema — el equipo define el problema y las restricciones. La IA opera dentro de ese marco, no lo infiere.
Reglas de negocio — no están en ningún dataset de entrenamiento. El equipo las documenta antes de que empiece la generación.
Decisiones de diseño — la IA genera alternativas; el equipo elige. No se delega.
Estándares de calidad — criterios de aceptación y umbrales de cobertura definidos por el equipo, aplicados por la IA.
Instrucciones de seguridad — el 44% del código generado por IA sin instrucciones de seguridad en el prompt introduce una vulnerabilidad conocida. El equipo define qué debe cumplir cada output antes de llegar a revisión.
Sin estos cinco puntos de control, es solo volumen sin gobierno.
Las 7 condiciones que determinan si la IA ayuda o perjudica
La investigación sobre casi 5.000 profesionales de tecnología identificó las condiciones que separan a los equipos que ganan velocidad y calidad de los que solo ganan velocidad:
- Una política de IA clara y comunicada
- Ecosistemas de datos saludables
- Datos internos accesibles para la IA
- Control de versiones sólido
- Trabajo en lotes pequeños
- Foco genuino en el usuario
- Plataformas internas de calidad — la más crítica
Sin las siete, la IA amplifica lo que ya está roto.
En qué nivel está tu organización realmente
La mayoría de las organizaciones que creen estar en el Nivel 3 están en el Nivel 2.
Nivel 1: Cada uno usa IA a su manera. Sin contexto compartido, sin estándares.
Nivel 2: Hay una política. Las especificaciones empiezan a existir. Pero ninguna es la fuente de verdad del equipo.
Nivel 3: Las especificaciones son la fuente de verdad. Las métricas y los gates de calidad están activos.
Nivel 4: IA embebida en todo el ciclo de entrega. Supervisión humana en cada punto crítico. Dashboard compartido actualizado varias veces al día.
La pregunta diagnóstica: ¿puede tu equipo mostrar un dashboard compartido con métricas en tiempo real — cobertura de código, tasa de descarte, frecuencia de deployment — actualizado varias veces al día? Si la respuesta es no, ya sabés en qué nivel estás.
La versión en una línea
La IA amplifica al equipo sobre el que aterriza. Un equipo completo con contexto estructurado, PDD, SDD y supervisión humana entrega a una velocidad que ningún modelo tradicional puede igualar. Un equipo sin esa infraestructura genera más código más rápido — y más problemas al mismo ritmo.
La infraestructura es lo que separa a los dos.
by Huenei IT Services | Sep 18, 2026 | Inteligencia Artificial
La Inteligencia Artificial está transformando la forma en que se desarrolla software. Pero aumentar la velocidad de construcción no garantiza mejores resultados. Sin los procesos adecuados, la IA puede acelerar problemas existentes: retrabajo, falta de trazabilidad, inconsistencias de calidad y decisiones tomadas sin el contexto de negocio necesario.
Este whitepaper explora qué diferencia a las organizaciones que simplemente adoptan herramientas de IA de aquellas que logran integrarla realmente en su ciclo de desarrollo de software.
Desde enfoques como Product-Driven Development (PDD), Spec-Driven Development (SDD) y modelos Human-in-the-Loop, el informe analiza cómo los equipos pueden incorporar IA en cada etapa del SDLC manteniendo calidad, seguridad y control.
En este whitepaper descubrirás:
- Por qué adoptar IA no garantiza mejores resultados en desarrollo de software.
- Cómo el contexto estructurado y las especificaciones mejoran el desarrollo asistido por IA.
- El rol del criterio humano en un modelo de desarrollo aumentado por IA.
- Las condiciones necesarias para escalar la adopción de IA de manera efectiva.
- Cómo la IA transforma capacidades clave como modernización, testing, integraciones y operaciones.
- Qué métricas permiten medir si la integración de IA realmente genera impacto.
by Huenei IT Services | Aug 24, 2026 | Data
El relato simple no alcanza
Cuando la CMF confirmó en junio de 2026 la postergación del Sistema de Finanzas Abiertas de julio de 2026 a julio de 2027, el titular que circuló fue predecible: Chile se atrasa un año en Open Finance.
Es un titular que cuenta la mitad de la historia.
La otra mitad es que Chile tiene, junto con Brasil, el marco regulatorio más completo de América Latina: sandbox regulatorio propio, siete categorías de servicios financieros tecnológicos ya definidas por ley, y una Norma de Carácter General —la NCG N°514— que cuando entre en vigencia va a regular no un sistema sino una industria entera. Eso no es un retraso de diseño. Es un retraso de ejecución, y la diferencia importa mucho para cualquier institución financiera que esté decidiendo cuándo y cuánto invertir en prepararse.
Un país con mal diseño regulatorio es una apuesta riesgosa, porque las reglas pueden cambiar de fondo. Un país con buen diseño y ejecución demorada, como Chile hoy, es lo opuesto: las reglas ya están escritas, lo único incierto es exactamente cuándo se van a aplicar. Eso convierte la espera en una decisión más cómoda. Pero no necesariamente más inteligente.
Lo que la postergación realmente dice
La CMF no postergó el SFA porque el proyecto fracasó. Lo postergó después de recibir más de 400 comentarios de 32 entidades durante la consulta pública, y lo que hizo junto con la nueva fecha lo dice todo: sumó un Anexo N°3 con especificaciones técnicas de interoperabilidad, un portal del desarrollador, y ambientes de prueba previos a la entrada en vigencia.
Eso no es ganar tiempo en abstracto. Es reconocer que faltaban piezas técnicas concretas para que el sistema funcionara en la práctica y no solo en el papel. La postergación fue, en ese sentido, una señal de madurez regulatoria, no de debilidad: el regulador eligió hacerlo bien antes que hacerlo rápido.
Para las instituciones que tienen que implementar, eso significa algo muy concreto: hay un año adicional disponible para construir con anticipación en lugar de bajo presión. La pregunta es si lo van a usar.
Los datos que incomodan
El Mapa Fintech Chile 2026 —elaborado por FinteChile y EY sobre 557 soluciones fintech operando en el país— contiene dos números que deberían llamar la atención de cualquier banco, aseguradora o cooperativa que lee este documento.
El primero: apenas el 3% de la inversión del ecosistema fintech chileno va hoy a cumplimiento regulatorio. Es el ítem más bajo de los seis que mide el estudio, incluso con el SFA entrando en vigencia en poco más de un año. Eso no significa necesariamente que las fintech vayan a incumplir la norma. Significa que la mayoría está eligiendo resolver el cumplimiento de forma reactiva, cuando la obligación ya esté encima, en lugar de usar el tiempo disponible ahora para construir con ventaja.
El segundo número es estructuralmente más profundo: apenas el 1,8% del ecosistema tiene como tecnología principal el acceso programático vía APIs para que terceros construyan encima. Que es exactamente la lógica que el SFA busca masificar. Casi un tercio del ecosistema sigue construyendo, ante todo, aplicaciones que el usuario final ve y toca directamente, incluso en empresas B2B. Open Finance como vertical tiene solo cinco empresas registradas en el mapa, con el SFA a un año de entrar en vigencia.
La lectura es clara: la regulación puede estar avanzada en el papel sin que exista todavía un mercado de proveedores ni una arquitectura técnica construida sobre ella. Chile tiene el diseño. Le falta la arquitectura.
El ecosistema que sí maduró
Lo que sí maduró en Chile es el ecosistema en sí. Las 557 fintech activas crecieron a una tasa compuesta del 16,7% entre 2021 y 2026, con una mortalidad de apenas el 6,3%. No es un ecosistema debilitado: es uno que pasó de premiar el volumen a premiar la eficiencia, la misma transición que se observó en México y Colombia un par de años antes.
El 46,3% de las fintech chilenas ya tiene alianzas activas con instituciones tradicionales, y los bancos concentran el 48% de esas alianzas. El 52% del ecosistema ya opera fuera de Chile. La relación entre fintech e incumbentes en Chile no es de disrupción pura: es de colaboración como estrategia de escalamiento dominante, especialmente en Lending e Insurtech, las verticales donde el riesgo regulatorio y la confianza del cliente pesan más.
Todo eso habla de un mercado que sabe cómo construir relaciones y cómo crecer con eficiencia. Lo que todavía no incorporó a esa lógica es la arquitectura técnica que el Open Finance requiere.
El problema no es de fechas, es de arquitectura
Las instituciones del Grupo 1 —bancos, emisores de tarjetas, compañías de seguros— tienen hasta julio de 2027. Las del Grupo 2 —cooperativas, administradoras de fondos, cajas de compensación— tienen 18 meses adicionales después de esa fecha. En términos de urgencia percibida, muchas están actuando como si la obligación fuera lejana. En términos de lo que hay que construir, no lo es.
Las instituciones que llegan a la obligatoriedad trabajando ya con estándares abiertos —APIs, modelos de consentimiento, infraestructura cloud-native, protocolos como OAuth 2.0 o FAPI— llegan con ventaja competitiva real, no con un costo de última hora bajo presión regulatoria. Las que esperan a que la norma entre en vigencia para empezar a diseñar esa arquitectura van a construir bajo presión de fecha límite, con margen casi nulo para pensar en casos de uso propios más allá del cumplimiento mínimo exigido.
La ventana sigue abierta. Pero no para siempre, y cada mes que pasa sin decisión de arquitectura es un mes menos de ventaja frente a quien ya empezó.
La pregunta que vale la pena hacerse hoy no es cuándo va a obligar la regulación. Es qué se puede construir con Open Finance antes de que lo haga.
by Huenei IT Services | Jul 28, 2026 | Data
Chile tiene hoy 557 soluciones fintech operando en su territorio, un marco regulatorio considerado el más completo de América Latina junto con Brasil, y el Sistema de Finanzas Abiertas postergado a julio de 2027.
Ese año adicional no es un obstáculo. Es una ventana.
En este whitepaper analizamos el estado real del ecosistema financiero chileno: los datos del Mapa Fintech Chile 2026, la línea de tiempo regulatoria del SFA, la comparativa regional, y lo que significa para bancos, aseguradoras y cooperativas que todavía están decidiendo cuándo empezar a construir.
La regulación ya está escrita. La arquitectura, en la mayoría de las instituciones, todavía no.
by Huenei IT Services | Jul 16, 2026 | Data
La pregunta que casi nadie se hace correctamente
Cuando una institución financiera en LATAM empieza a hablar de Open Finance, la conversación suele abrirse con la misma pregunta: ¿cuándo nos va a obligar la regulación y cuánto va a costar cumplir?
Es una pregunta comprensible. Los equipos de compliance y tecnología necesitan planificar y presupuestar. Pero es, casi siempre, la pregunta equivocada.
Las instituciones que se enfocan en ella llegan exactamente donde esa pregunta las lleva: al mínimo cumplimiento regulatorio, sin ninguna ventaja competitiva real. Construyen lo que la regulación exige, en el tiempo que la regulación impone, y terminan adaptándose a un ecosistema que otros ya diseñaron.
La pregunta correcta es otra: ¿qué podemos construir con Open Finance que antes era imposible?
Esta distinción (entre ver Open Finance como obligación o como infraestructura estratégica) es la que separa a las instituciones que van a liderar la transformación financiera en LATAM de las que van a reaccionar ante ella.
El mapa regulatorio: dónde está cada país y qué implica
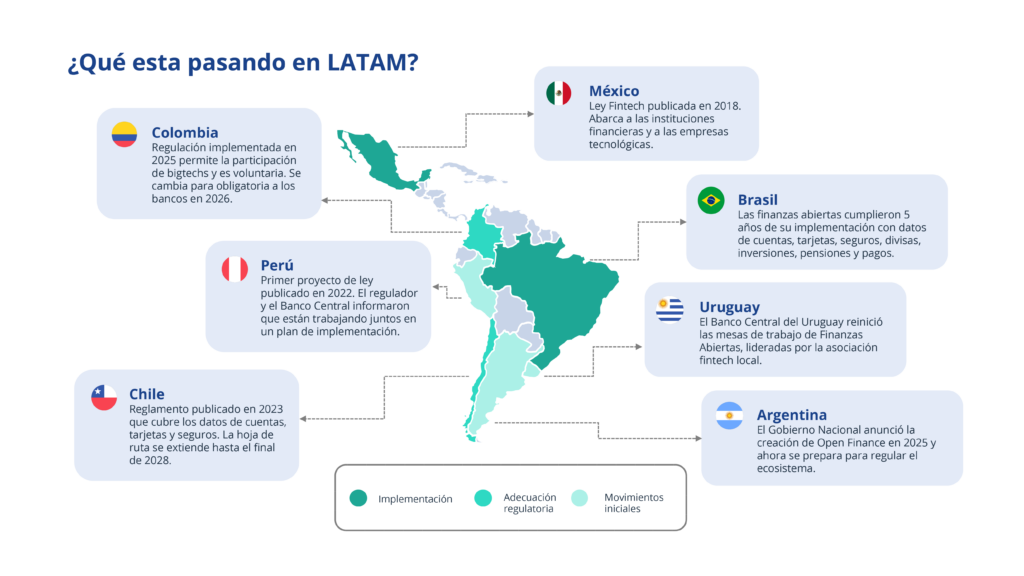
LATAM no es un mercado uniforme en materia de Open Finance. Cada país está en una etapa diferente, con implicaciones distintas para las instituciones que operan en la región.
Brasil lidera con claridad: lleva más de cinco años de implementación con datos de cuentas, tarjetas, seguros, divisas, inversiones, pensiones y pagos. El ecosistema brasileño ya produce casos de uso concretos y medibles. Nubank utilizó datos de Open Finance para ahorrar a sus clientes R$8 millones en intereses en diez meses. Mercado Pago otorgó crédito a más de 30.000 personas, de las cuales el 53% considera que el acceso a sus datos financieros a través de Open Finance fue esencial para obtenerlo.
Colombia implementó su regulación en 2025 con participación voluntaria, pero la obligatoriedad para bancos entra en vigencia en 2026. Chile publicó su reglamento en 2023 con una hoja de ruta que se extiende hasta 2028. Argentina anunció la creación del ecosistema en 2025 y está definiendo la regulación ahora mismo. México tiene la Ley Fintech desde 2018. Perú y Uruguay están en etapas iniciales de planificación.
Lo que el mapa muestra es que la ventana de early mover está en momentos muy diferentes según el mercado. En Brasil ya cerró. En Colombia se está cerrando. En Argentina, Chile y México todavía está abierta. Las instituciones que actúen antes de que la regulación los obligue no solo van a cumplir: van a participar en la definición de los estándares, las integraciones y los modelos de negocio que van a gobernar el ecosistema financiero de la región durante la próxima década.
Lo que Open Finance hace posible que antes era imposible
Open Finance no es una evolución del home banking. Es un cambio de modelo: el paso de ecosistemas cerrados donde las instituciones controlan la información, a economías abiertas donde los datos fluyen de forma segura entre bancos, aseguradoras, fondos de inversión, fintechs y otros participantes autorizados, con el consentimiento explícito del cliente.
Eso habilita modelos de negocio que antes no existían:
- Banking as a Service: cualquier empresa puede ofrecer productos bancarios. Los bancos se convierten en plataformas B2B que proveen infraestructura financiera a terceros.
- Embedded Finance: crédito, seguro y pagos integrados directamente en el retailer, el marketplace o el e-commerce, sin que el cliente tenga que salir de la experiencia que ya está usando.
- Data Marketplace: los datos financieros anonimizados se convierten en un activo comercial. Scoring alternativo, insights de comportamiento, analítica predictiva. Inclusión financiera para segmentos que el modelo tradicional no alcanzaba.
- RegTech integrado: APIs para AML, KYC y detección de fraude que convierten la regulación en ventaja competitiva para las instituciones más ágiles.
Cada uno de estos modelos requiere una base tecnológica que no se construye en semanas. Requiere APIs bien diseñadas, plataformas de consentimiento robustas, arquitecturas que soporten el intercambio seguro de datos entre múltiples actores, y equipos que entiendan tanto la regulación local como los estándares internacionales.
Los tres pilares que hay que resolver al mismo tiempo
La implementación de Open Finance no es un proyecto de tecnología. Es una transformación que exige alinear tres pilares simultáneamente:
Tecnología y datos: ¿cuál es la arquitectura de APIs? ¿Qué estructura de gobierno hace falta? ¿Los datos internos tienen la calidad suficiente para ser compartidos con garantías? Sin una base tecnológica sólida, el resto no escala.
- Estrategia: ¿cuál es el modelo de negocio? ¿Cuáles son las fuentes de ingreso en un ecosistema abierto? ¿Cómo se posiciona la institución frente a fintechs y bigtechs que van a aprovechar el mismo ecosistema? La estrategia define para qué se usa la tecnología.
- Producto y servicio: ¿a qué clientes apuntamos? ¿Cuál es la propuesta de valor concreta? Open Finance solo genera impacto si se traduce en productos que el cliente elige usar.
Y debajo de los tres: cultura. La capacidad de compartir datos, de colaborar con terceros, de repensar la propuesta de valor desde cero, no se instala con una plataforma. Requiere una organización dispuesta a cambiar cómo crea valor.
El momento es ahora
Las organizaciones que actúen durante esta ventana no solo van a cumplir con las regulaciones que vengan. Van a capturar nuevas fuentes de ingreso mediante la monetización de APIs. Van a fidelizar clientes con experiencias personalizadas que un modelo cerrado no puede ofrecer. Van a reducir costos operativos a través de eficiencias de ecosistema. Y van a acumular datos, experiencia y ventaja competitiva que se compone con el tiempo.
Las que esperen van a llegar a un ecosistema que otros ya diseñaron. Y adaptarse a las reglas de un juego que no definiste siempre es más caro y más lento que haberlo jugado desde el principio.
La conversación correcta no empieza con ‘¿cuándo nos obliga la regulación?’. Empieza con ‘¿qué podemos construir ahora que antes era imposible?’. Y esa conversación puede comenzar hoy.